A digitalização dos processos documentais trouxe enormes ganhos às organizações. No entanto, a introdução manual de informação continua a ser frequente.
Os documentos deixaram de circular exclusivamente em papel, passaram a ser carregados em plataformas e podem hoje ser consultados praticamente a partir de qualquer lugar.
Mas existe uma parte do processo que, em muitas organizações, continua praticamente inalterada.
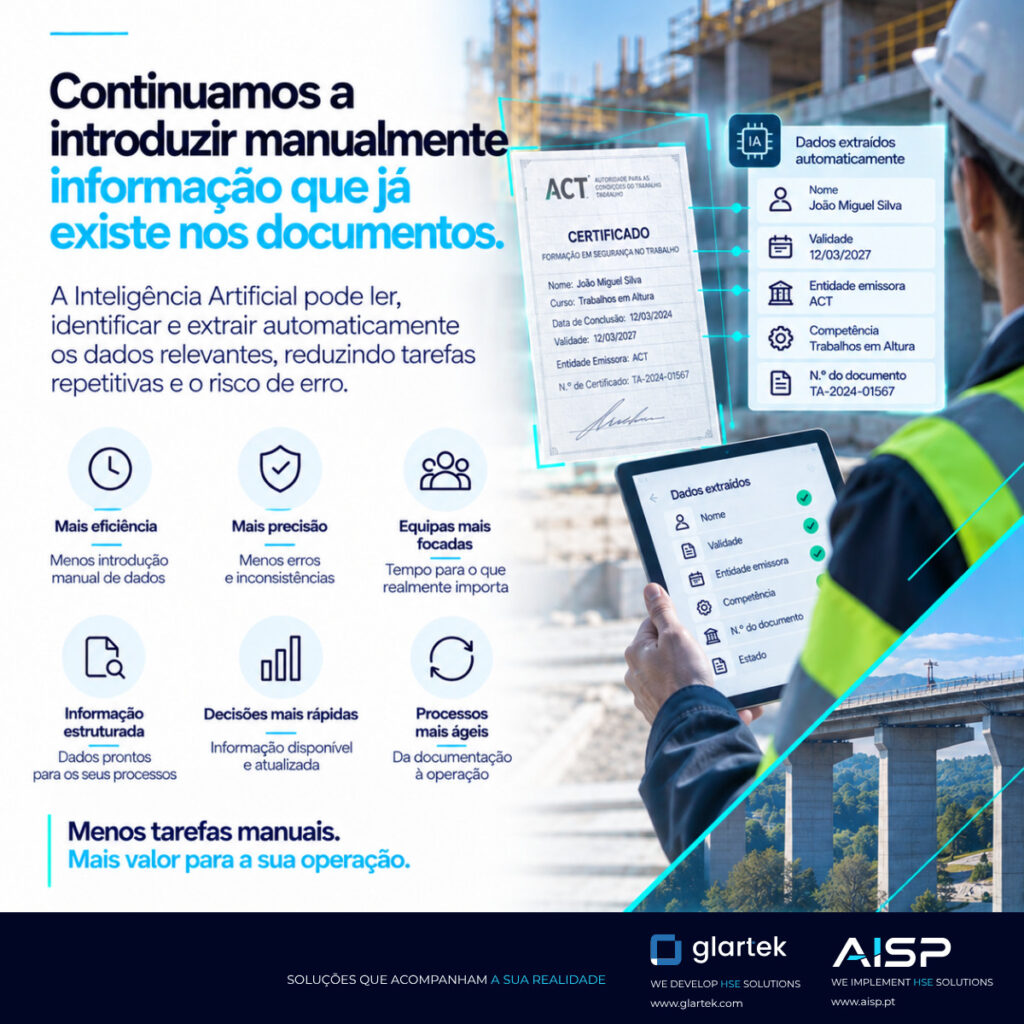
A informação que já está dentro dos documentos continua a ser introduzida manualmente noutros sistemas.
Por exemplo, um colaborador abre um certificado, procura o nome, identifica a entidade emissora, verifica a data de validade, lê a competência e copia cada um destes elementos para campos da plataforma.
O ficheiro é digital.
O processo, no entanto, continua parcialmente manual.
O custo escondido da introdução manual
Quando analisamos apenas um documento, copiar alguns campos pode parecer uma tarefa insignificante.
O problema surge quando esta operação é repetida centenas ou milhares de vezes.
Por exemplo, uma organização que gere documentação de trabalhadores, fornecedores e equipamentos pode receber diariamente um volume significativo de:
- certificados de formação;
- fichas de aptidão;
- declarações;
- apólices;
- relatórios;
- inspeções;
- certificados técnicos;
- licenças;
- autorizações;
- registos de manutenção.
Na verdade, cada documento pode obrigar a abrir, interpretar, localizar e transcrever diferentes elementos de informação.
Assim, o resultado é uma quantidade relevante de tempo dedicada a tarefas que não acrescentam diretamente conhecimento ao processo.
Introdução manual de informação que já existe
Por exemplo, considere um certificado de formação.
O documento pode conter:
- nome do trabalhador;
- entidade emissora;
- designação da formação;
- número do certificado;
- data de emissão;
- data de validade;
- duração;
- competência adquirida.
Se estes dados já estão no documento, porque devem ser novamente introduzidos manualmente?
Por isso, é aqui que tecnologias de OCR e Inteligência Artificial podem apoiar uma nova abordagem.
Da leitura automática à extração estruturada
O primeiro passo é conseguir ler o documento.
Mas ler não é suficiente.
No entanto, uma solução inteligente deve conseguir identificar o significado da informação.
Por exemplo, encontrar uma data não basta.
É necessário perceber se corresponde à data de emissão, à validade ou a outra referência.
Encontrar o nome de uma empresa também não significa saber automaticamente se corresponde à entidade emissora, ao empregador ou ao cliente.
Por isso, um processo robusto precisa de combinar diferentes capacidades:
Leitura → identificação → extração → estruturação → validação
Assim, o objetivo é transformar elementos existentes no documento em dados estruturados que possam ser utilizados pelos restantes processos.
O que pode ser extraído?
Dependendo do tipo documental, podem ser extraídos dados como:
- nome do titular;
- empresa;
- entidade emissora;
- número do documento;
- datas;
- validade;
- competência;
- formação;
- função;
- equipamento;
- número de série;
- resultado;
- referências específicas.
Na verdade, a informação relevante varia de documento para documento.
É por isso que a configuração do processo continua a ser essencial.
Menos introdução manual, menos possibilidade de erro
Além disso, a transcrição manual é repetitiva e está sujeita a falhas.
Podem ocorrer:
- erros em datas;
- nomes escritos incorretamente;
- números de certificado incompletos;
- associação ao trabalhador errado;
- classificação incorreta;
- informação omitida.
Assim, a extração automática pode reduzir grande parte desta transcrição.
Desta forma, as equipas passam a concentrar-se mais na validação das exceções e menos na cópia de dados.
Sem introdução manual, a informação alimenta outros processos
No entanto, o verdadeiro ganho não termina na extração.
Quando a informação é estruturada, pode ser utilizada por diferentes componentes da organização.
Por exemplo, uma data de validade pode gerar um alerta.
Do mesmo modo, uma competência pode alimentar uma matriz de competências.
O titular pode ser comparado com o trabalhador associado ao documento.
Além disso, a entidade emissora pode fazer parte das regras de validação.
Os dados podem alimentar dashboards e indicadores.
A documentação passa, assim, de uma lógica estática para uma lógica operacional.
Extrair não significa aprovar
Existe, no entanto, uma distinção fundamental.
No entanto, a capacidade de extrair informação de um documento não significa que a plataforma deva aprová-lo automaticamente.
Um certificado pode indicar “Trabalhos em Altura”, mas ainda pode ser necessário verificar:
- se pertence à pessoa correta;
- se está dentro da validade;
- se corresponde ao requisito do projeto;
- se a entidade emissora é adequada;
- se a formação é suficiente para a função;
- se existem outros requisitos obrigatórios.
Por isso:
extração de dados ≠ decisão de conformidade
Ou seja, a extração reduz tarefas administrativas.
No entanto, a conformidade exige regras, contexto e critérios de decisão.
Quando a análise humana continua necessária
Na verdade, nem todos os documentos são claros.
Existem documentos digitalizados com baixa qualidade, informação contraditória, campos incompletos ou terminologia difícil de interpretar.
Por isso, nesses casos, a tecnologia deve saber parar.
Quando não existe informação suficiente para uma decisão segura, o documento deve seguir para análise humana.
Assim, a automação eficiente não é aquela que tenta decidir tudo.
É aquela que automatiza o que é claro e encaminha corretamente as exceções.
Dados documentais ao serviço da operação
Quando os dados são estruturados, tornam-se possíveis processos que anteriormente exigiam consulta manual.
Por exemplo:
- identificar documentos próximos da expiração;
- saber que trabalhadores possuem uma competência;
- visualizar fornecedores com requisitos pendentes;
- acompanhar documentação por projeto;
- alimentar dashboards de conformidade;
- identificar prioridades de análise.
Assim, a informação deixa de estar fechada dentro dos ficheiros.
Desta forma, passa a estar disponível para apoiar a decisão.
Da documentação à operação
A evolução pode ser resumida assim:
Modelo tradicional:
Documento → leitura humana → introdução manual → validação
Modelo apoiado por IA:
Documento → extração de dados → estruturação → regras → validação → decisão
No entanto, o documento continua a ser a evidência original.
Mas a equipa deixa de ter de repetir manualmente a informação que já existe.
Menos introdução manual. Mais valor humano.
O objetivo da Inteligência Artificial na Gestão Documental não deve ser substituir o conhecimento das equipas.
Deve ser utilizá-lo melhor.
Um técnico especializado acrescenta mais valor a analisar uma situação ambígua, uma não conformidade ou um requisito complexo do que a copiar uma data de validade de um PDF para um campo.
Na verdade, é precisamente aí que está uma das maiores oportunidades da automação documental.
Retirar às pessoas as tarefas repetitivas para lhes devolver tempo para tarefas que exigem julgamento, conhecimento e decisão.
A informação já existe dentro dos documentos.
A tecnologia pode ajudar a extraí-la. E as equipas podem concentrar-se naquilo que realmente exige inteligência humana.
Leia também: Automação na gestão documental e Redução de custos e melhoria da produtividade.
Para conhecer o enquadramento europeu sobre inteligência artificial e transformação digital, consulte a estratégia digital da Comissão Europeia.