
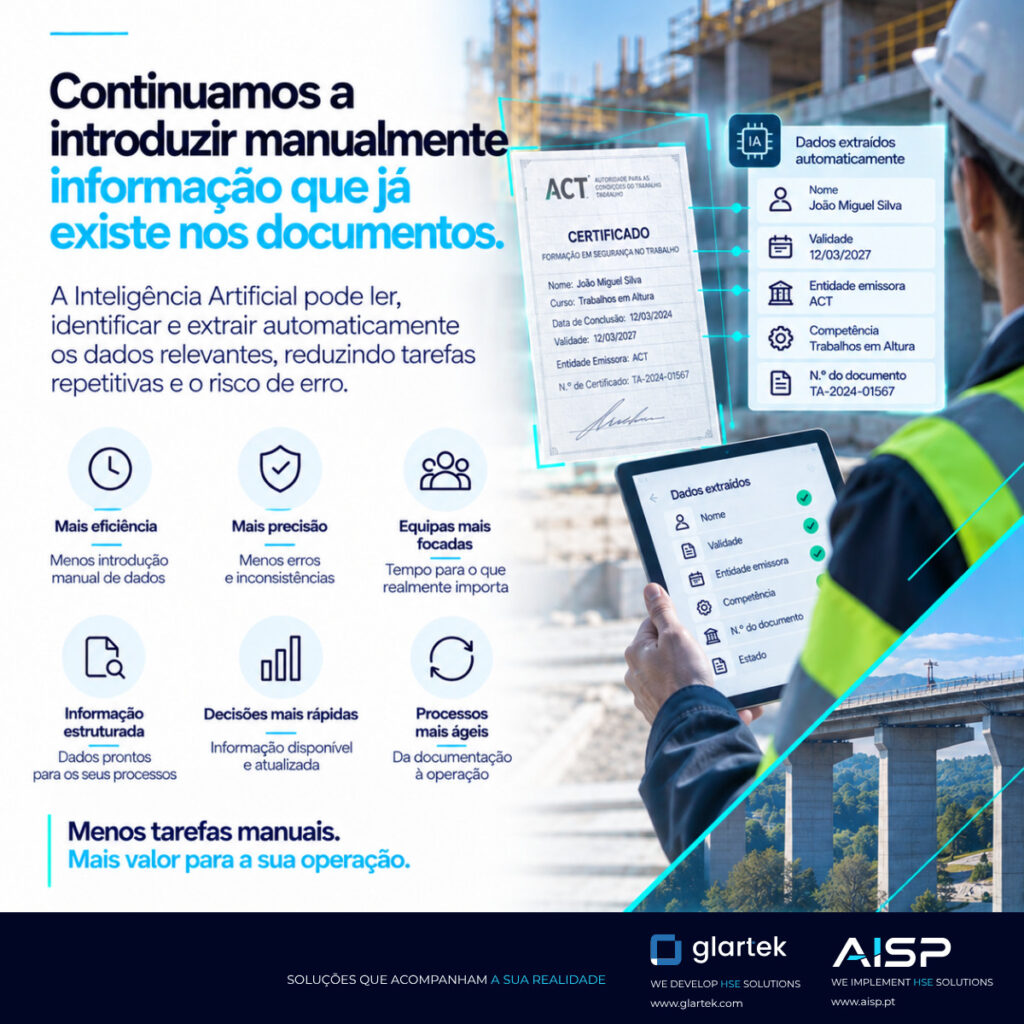
La numérisation des processus documentaires a apporté des gains considérables aux organisations. Pourtant, la saisie manuelle des données reste fréquente.
Les documents ne circulent plus exclusivement sur papier : ils sont chargés sur des plateformes et peuvent aujourd’hui être consultés pratiquement depuis n’importe où.
Toutefois, dans de nombreuses organisations, une partie du processus reste pratiquement inchangée.
Les informations qui figurent déjà dans les documents continuent d’être saisies manuellement dans d’autres systèmes.
Par exemple, un collaborateur ouvre un certificat, cherche le nom, identifie l’organisme émetteur, vérifie la date d’expiration, lit la compétence et recopie chacun de ces éléments dans les champs de la plateforme.
Le fichier est numérique.
Pourtant, le processus reste en partie manuel.
Le coût caché de la saisie manuelle
Lorsqu’on analyse un seul document, recopier quelques champs peut sembler une tâche insignifiante.
Le problème apparaît lorsque cette opération se répète des centaines ou des milliers de fois.
Par exemple, une organisation qui gère les documents d’intervenants, de fournisseurs et d’équipements peut recevoir chaque jour un volume important de :
- certificats de formation ;
- fiches d’aptitude ;
- déclarations ;
- polices d’assurance ;
- rapports ;
- inspections ;
- certificats techniques ;
- licences ;
- autorisations ;
- registres de maintenance.
En effet, chaque document peut obliger à ouvrir, interpréter, localiser et retranscrire différents éléments d’information.
Ainsi, le résultat est un temps considérable consacré à des tâches qui n’apportent pas directement de connaissance au processus.
Saisie manuelle des données qui existent déjà
Prenons par exemple un certificat de formation.
Le document peut contenir :
- nom de l’intervenant ;
- organisme émetteur ;
- intitulé de la formation ;
- numéro du certificat ;
- date d’émission ;
- date d’expiration ;
- durée ;
- compétence acquise.
Si ces données figurent déjà dans le document, pourquoi faudrait-il les saisir à nouveau manuellement ?
C’est précisément là que les technologies d’OCR et d’intelligence artificielle peuvent soutenir une nouvelle approche.
De la lecture automatique à l’extraction structurée
La première étape consiste à pouvoir lire le document.
Mais lire ne suffit pas.
Une solution intelligente doit aussi pouvoir identifier le sens de l’information.
Par exemple, trouver une date ne suffit pas.
Il faut comprendre s’il s’agit de la date d’émission, de la date d’expiration ou d’une autre référence.
De même, trouver le nom d’une entreprise ne signifie pas savoir automatiquement s’il s’agit de l’organisme émetteur, de l’employeur ou du client.
C’est pourquoi un processus robuste doit combiner différentes capacités :
Lecture → identification → extraction → structuration → validation
Ainsi, l’objectif est de transformer les éléments présents dans le document en données structurées utilisables par les autres processus.
Que peut-on extraire ?
Selon le type de document, il est possible d’extraire des données comme :
- nom du titulaire ;
- entreprise ;
- organisme émetteur ;
- numéro du document ;
- dates ;
- date d’expiration ;
- compétence ;
- formation ;
- fonction ;
- équipement ;
- numéro de série ;
- résultat ;
- références spécifiques.
En effet, les informations pertinentes varient d’un document à l’autre.
C’est pourquoi la configuration du processus reste essentielle.
Moins de saisie manuelle, moins de risques d’erreur
De plus, la retranscription manuelle est répétitive et sujette aux erreurs.
Il peut s’agir de :
- erreurs de dates ;
- noms mal orthographiés ;
- numéros de certificat incomplets ;
- rattachement au mauvais intervenant ;
- classification incorrecte ;
- informations omises.
Ainsi, l’extraction automatique peut réduire une grande partie de cette retranscription.
De cette façon, les équipes se concentrent davantage sur la validation des exceptions et moins sur la copie de données.
Sans saisie manuelle, l’information alimente d’autres processus
Cependant, le véritable gain ne s’arrête pas à l’extraction.
Lorsque l’information est structurée, différents composants de l’organisation peuvent l’utiliser.
Par exemple, une date d’expiration peut générer une alerte.
De même, une compétence peut alimenter une matrice de compétences.
Le titulaire peut être comparé à l’intervenant associé au document.
En outre, l’organisme émetteur peut faire partie des règles de validation.
Les données peuvent alimenter des tableaux de bord et des indicateurs.
La documentation passe ainsi d’une logique statique à une logique opérationnelle.
Extraire ne signifie pas approuver
Il existe toutefois une distinction fondamentale.
La capacité à extraire des informations d’un document ne signifie pas que la plateforme doive l’approuver automatiquement.
Un certificat peut indiquer « Travaux en hauteur », mais il peut encore être nécessaire de vérifier :
- appartenance à la bonne personne ;
- date d’expiration non dépassée ;
- correspondance avec l’exigence du projet ;
- adéquation de l’organisme émetteur ;
- formation suffisante pour la fonction ;
- existence d’autres exigences obligatoires.
C’est pourquoi :
extraction de données ≠ décision de conformité
Autrement dit, l’extraction réduit les tâches administratives.
Cependant, la conformité exige des règles, un contexte et des critères de décision.
Quand l’analyse humaine reste nécessaire
En réalité, tous les documents ne sont pas clairs.
Certains documents numérisés sont de mauvaise qualité, contiennent des informations contradictoires, des champs incomplets ou une terminologie difficile à interpréter.
C’est pourquoi, dans ces cas, la technologie doit savoir s’arrêter.
Lorsque les informations sont insuffisantes pour une décision sûre, le document doit passer en analyse humaine.
Ainsi, l’automatisation efficace n’est pas celle qui tente de tout décider.
C’est celle qui automatise ce qui est clair et oriente correctement les exceptions.
Les données documentaires au service de l’opération
Lorsque les données sont structurées, des processus qui exigeaient auparavant une consultation manuelle deviennent possibles.
Par exemple :
- identifier les documents proches de l’expiration ;
- savoir quels intervenants possèdent une compétence ;
- visualiser les fournisseurs ayant des exigences en attente ;
- suivre la documentation par projet ;
- alimenter des tableaux de bord de conformité ;
- identifier les priorités d’analyse.
Ainsi, l’information n’est plus enfermée dans les fichiers.
De cette façon, elle devient disponible pour soutenir la décision.
De la documentation à l’opération
L’évolution peut se résumer ainsi :
Modèle traditionnel :
Document → lecture humaine → saisie manuelle → validation
Modèle assisté par l’IA :
Document → extraction des données → structuration → règles → validation → décision
Toutefois, le document reste la preuve originale.
Mais l’équipe n’a plus à répéter manuellement des informations qui existent déjà.
Moins de saisie manuelle. Plus de valeur humaine.
L’objectif de l’intelligence artificielle dans la gestion documentaire ne doit pas être de remplacer le savoir des équipes.
Il doit être de mieux l’utiliser.
Un technicien spécialisé apporte plus de valeur en analysant une situation ambiguë, une non-conformité ou une exigence complexe qu’en copiant une date d’expiration d’un PDF vers un champ.
En effet, c’est précisément là que réside l’une des plus grandes opportunités de l’automatisation documentaire.
Retirer aux personnes les tâches répétitives pour leur redonner du temps pour les tâches qui exigent du jugement, des connaissances et des décisions.
L’information existe déjà dans les documents.
La technologie peut aider à l’extraire. Et les équipes peuvent se concentrer sur ce qui exige réellement l’intelligence humaine.
À lire aussi : L’automatisation dans la gestion documentaire et Réduction des coûts et amélioration de la productivité.
Pour découvrir le cadre européen en matière d’intelligence artificielle et de transformation numérique, consultez la stratégie numérique de la Commission européenne.