
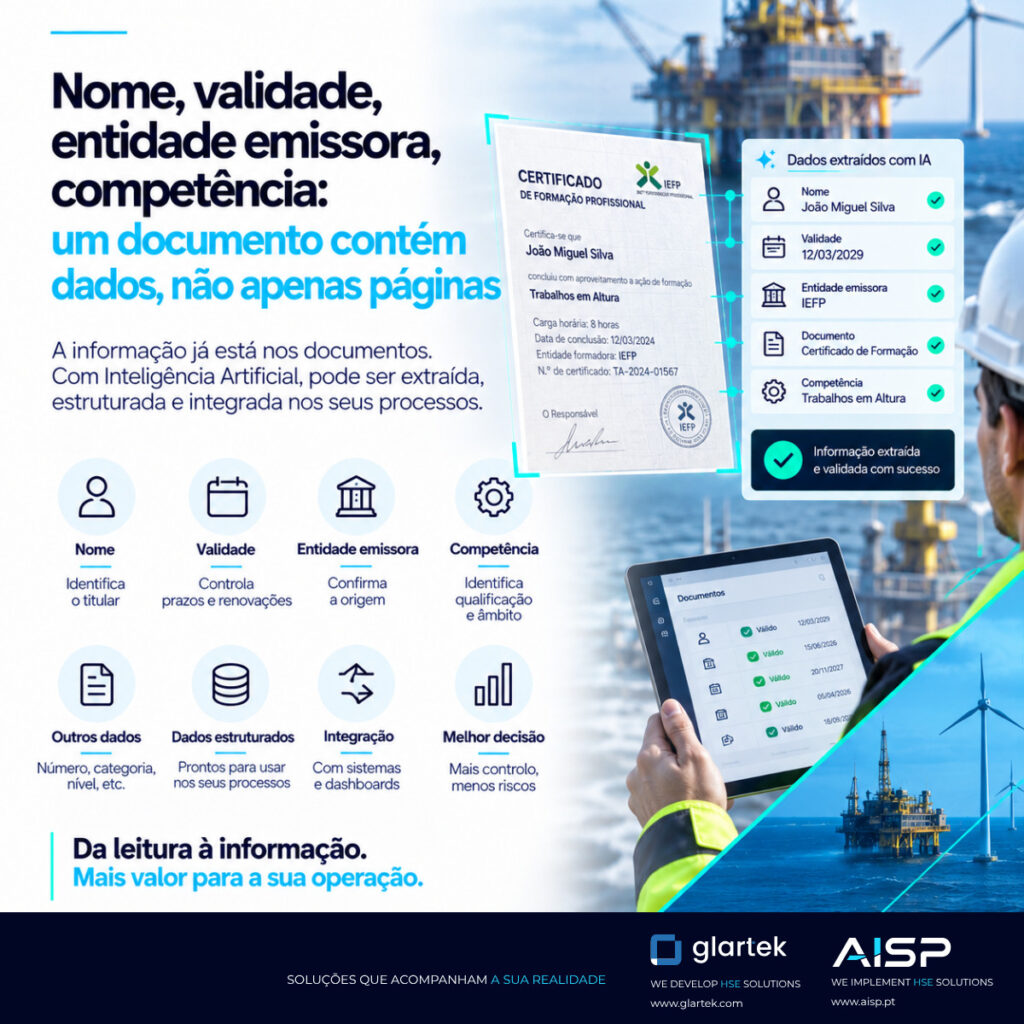
Un document numérique n’est pas seulement un ensemble de pages stockées sur une plateforme. Les données des documents ont, elles aussi, de la valeur.
Un certificat, un rapport, une déclaration, une police d’assurance, une fiche technique ou un registre contiennent des informations qui peuvent être identifiées, structurées et utilisées par d’autres processus de l’organisation.
Noms, dates, organismes émetteurs, compétences, numéros de certificat, références, résultats ou échéances : autant de données que de nombreuses organisations continuent de consulter manuellement chaque fois qu’elles en ont besoin.
C’est pourquoi l’évolution de la gestion documentaire passe précisément par un changement de logique.
Au lieu de traiter le document uniquement comme un fichier, il devient possible de le traiter aussi comme une source de données.
Le document contient déjà l’information
Prenons, par exemple, une attestation de formation.
Visuellement, nous avons un document.
Pourtant, du point de vue du processus, il peut contenir différents éléments d’information :
- nom de l’intervenant ;
- numéro d’identification ;
- formation suivie ;
- compétence acquise ;
- organisme de formation ;
- date d’émission ;
- date d’expiration ;
- durée ;
- référence du certificat.
En réalité, chacun de ces éléments peut être utile à une décision différente.
Par exemple, la date d’expiration peut déclencher une alerte.
De plus, la compétence peut être rattachée à une fonction.
L’organisme émetteur peut faire partie des règles de validation.
Enfin, le titulaire peut être comparé à l’intervenant auquel le document a été associé.
L’information existait déjà. Toutefois, le problème était qu’elle restait enfermée dans la page.
Quand un PDF exige encore un travail manuel
Numériser les processus ne consiste pas simplement à remplacer le papier par le PDF.
Si, après le chargement d’un document sur une plateforme, quelqu’un doit encore l’ouvrir, repérer les champs utiles et saisir les mêmes données à la main, une partie importante du processus fonctionne toujours comme avant.
Cela devient particulièrement important lorsqu’il y a des centaines ou des milliers de documents.
Ainsi, de petites tâches répétées de nombreuses fois se transforment en heures importantes de travail administratif.
En outre, les risques d’erreur de transcription, de classement ou d’association augmentent.
Transformer le contenu des documents en données structurées
Les technologies d’OCR et d’intelligence artificielle aident à identifier les informations présentes dans les documents.
Cependant, l’objectif n’est pas simplement de reproduire tout le texte.
En réalité, il s’agit d’identifier les champs qui ont un sens pour le processus.
Par exemple, dans un certificat, c’est la formation qui peut compter.
Dans une police d’assurance, ce sont l’assureur, le numéro de police et la date d’expiration.
Dans un certificat d’équipement, ce peuvent être le numéro de série, l’inspection et la prochaine révision.
Dans une fiche d’aptitude, certains éléments permettent de déterminer si la preuve présentée répond à l’exigence applicable.
Ainsi, la structure dépend toujours du type de document et du processus que l’organisation souhaite maîtriser.
Les données des documents peuvent alimenter les validations
Lorsque les données ne sont plus enfermées dans les documents, les règles de la plateforme peuvent les utiliser.
Par exemple, l’extraction de la date d’expiration permet de vérifier automatiquement si le document respecte le délai défini.
Par ailleurs, l’identité du titulaire peut être comparée à celle de l’intervenant associé.
Dans le même esprit, une compétence peut être confrontée aux exigences d’une fonction donnée.
L’organisme émetteur peut être analysé selon des critères définis au préalable.
Ainsi, l’analyse ne dépend plus uniquement de la lecture du fichier.
Des données des documents aux matrices de compétences
Cette approche est particulièrement utile pour les organisations qui doivent maîtriser les compétences.
Imaginez, par exemple, une entreprise comptant des centaines d’intervenants et différentes fonctions.
Au lieu de conserver l’information uniquement dans les certificats, les données extraites peuvent aider à construire une vue d’ensemble sur :
- qui possède une compétence donnée ;
- quand elle a été acquise ;
- jusqu’à quand elle est valable ;
- quelle preuve documentaire la justifie ;
- pour quelles fonctions elle est nécessaire ;
- qui doit la renouveler.
Le document continue néanmoins de servir de preuve.
Mais l’information alimente aussi la gestion opérationnelle.
Des alertes basées sur les données des documents
Prenons aussi l’exemple de la date d’expiration.
Tant que la date n’existe que dans un PDF, quelqu’un devra la consulter ou l’enregistrer manuellement.
Une fois structurée, elle peut générer automatiquement :
- des alertes d’expiration ;
- des listes de documents à renouveler ;
- des notifications ;
- des indicateurs ;
- une priorisation des tâches.
Le document cesse donc d’être passif.
Ainsi, l’information qu’il contient déclenche des processus.
Des tableaux de bord sans ouvrir de fichiers
De plus, la même logique s’applique aux indicateurs.
Une plateforme aux données structurées peut présenter des informations telles que :
- documents valides ;
- documents expirés ;
- intervenants par compétence ;
- fournisseurs avec documentation en attente ;
- certifications à renouveler ;
- exigences non satisfaites ;
- niveaux de conformité par projet.
De cette façon, les équipes n’ont plus besoin d’ouvrir chaque fichier pour répondre à des questions opérationnelles de base.
Les données extraites des documents ont besoin de contexte
Cependant, extraire une information ne signifie pas automatiquement l’interpréter correctement.
Une date repérée dans un document peut être une date d’émission, d’expiration, d’inspection ou de révision.
Une compétence peut apparaître parce que l’intervenant la possède, ou simplement parce qu’elle est citée dans un texte.
De même, une entité peut être l’organisme émetteur, le client ou une autre organisation mentionnée.
C’est pourquoi une solution robuste doit combiner :
extraction + structure + règles + contexte.
En réalité, c’est cette combinaison qui permet de transformer du texte en information exploitable.
L’IA comme appui, pas comme absence de contrôle
L’intelligence artificielle peut accélérer considérablement la lecture et la structuration documentaire.
Toutefois, des mécanismes doivent exister pour gérer l’incertitude.
Lorsque le système ne parvient pas à identifier un champ avec certitude, trouve des informations contradictoires ou manque de preuves suffisantes, le processus doit permettre d’orienter le document vers une analyse humaine.
L’automatisation apporte de la valeur lorsqu’elle réduit le travail répétitif et préserve la rigueur des décisions.
Le document alimente désormais le processus
Le grand changement peut se résumer simplement.
Dans un modèle traditionnel :
Document → consultation humaine
Dans un modèle plus avancé :
Document → données → validation → processus → décision
Le fichier reste néanmoins important.
Mais il n’est plus le point final.
Il devient une source d’information pour différents services de l’organisation.
Des pages à l’information opérationnelle
C’est précisément là que réside le potentiel de la nouvelle génération de gestion documentaire.
Les documents que les organisations reçoivent déjà contiennent une grande partie de l’information nécessaire à leurs processus.
La question est donc de savoir l’exploiter.
Extraire et structurer ces données permet de réduire la saisie manuelle, d’améliorer la traçabilité, d’accélérer les validations et de créer des indicateurs plus utiles pour l’exploitation.
Car un document ne contient pas seulement des pages.
Il contient des données qui peuvent alimenter les décisions.
À lire aussi : Automatisation de la gestion documentaire et Intelligence artificielle et machine learning pour la détection de schémas anormaux.
Pour connaître les règles applicables au traitement des données personnelles dans les documents, consultez la Commission nationale de protection des données du Portugal (CNPD).