
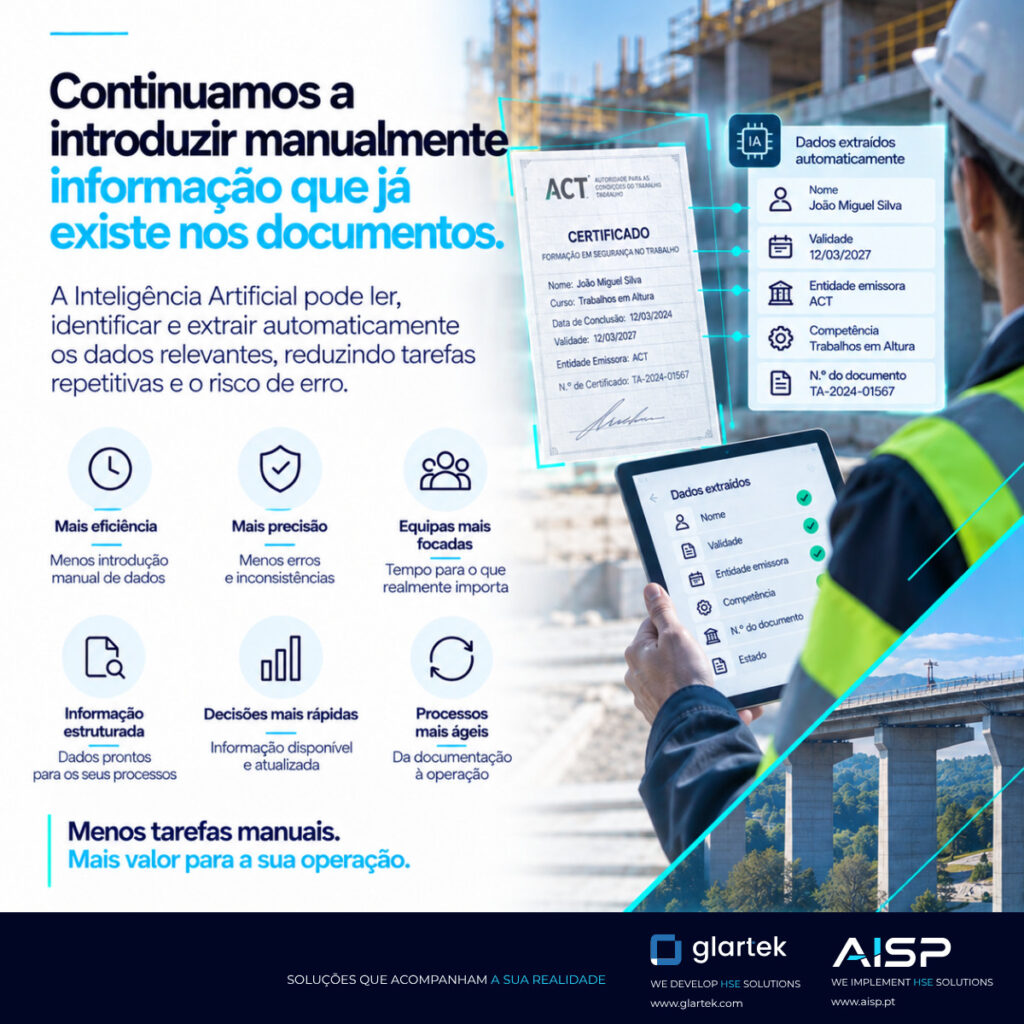
La digitalización de los procesos documentales ha aportado enormes ventajas a las organizaciones. Sin embargo, la introducción manual de datos sigue siendo frecuente.
Los documentos ya no circulan solo en papel. Ahora los equipos los suben a plataformas y pueden consultarlos prácticamente desde cualquier lugar.
Pero, en muchas organizaciones, una parte del proceso sigue prácticamente igual.
Los equipos siguen introduciendo a mano en otros sistemas la información que ya está dentro de los documentos.
Por ejemplo, un empleado abre un certificado, busca el nombre, identifica la entidad emisora, comprueba la fecha de caducidad, lee la competencia y copia cada uno de estos datos en los campos de la plataforma.
El archivo es digital.
El proceso, sin embargo, sigue siendo en parte manual.
El coste oculto de la introducción manual de datos
Cuando analizamos un solo documento, copiar algunos campos puede parecer una tarea insignificante.
El problema surge cuando esta operación se repite cientos o miles de veces.
Por ejemplo, una organización que gestiona la documentación de trabajadores, proveedores y equipos puede recibir cada día un volumen importante de:
- certificados de formación;
- certificados de aptitud médica;
- declaraciones;
- pólizas de seguro;
- informes;
- inspecciones;
- certificados técnicos;
- licencias;
- autorizaciones;
- registros de mantenimiento.
De hecho, cada documento puede obligar a abrir, interpretar, localizar y transcribir distintos datos.
Como resultado, se dedica mucho tiempo a tareas que no aportan directamente conocimiento al proceso.
Introducción manual de datos que ya existen
Por ejemplo, piense en un certificado de formación.
El documento puede contener:
- nombre del trabajador;
- entidad emisora;
- denominación de la formación;
- número del certificado;
- fecha de emisión;
- fecha de caducidad;
- duración;
- competencia adquirida.
Si estos datos ya están en el documento, ¿por qué hay que volver a introducirlos a mano?
Por eso, aquí es donde las tecnologías de OCR e inteligencia artificial pueden apoyar un nuevo enfoque.
De la lectura automática a la extracción estructurada
El primer paso es poder leer el documento.
Pero leer no basta.
Además, una solución inteligente debe poder identificar el significado de la información.
Por ejemplo, encontrar una fecha no es suficiente.
Hay que entender si corresponde a la fecha de emisión, a la fecha de caducidad o a otra referencia.
Del mismo modo, encontrar el nombre de una empresa no indica automáticamente si se trata de la entidad emisora, del empleador o del cliente.
Por lo tanto, un proceso robusto necesita combinar distintas capacidades:
Lectura → identificación → extracción → estructuración → validación
Así, el objetivo es convertir los datos del documento en datos estructurados que los demás procesos puedan utilizar.
¿Qué se puede extraer?
Según el tipo documental, es posible extraer datos como:
- nombre del titular;
- empresa;
- entidad emisora;
- número del documento;
- fechas;
- caducidad;
- competencia;
- formación;
- función;
- equipo;
- número de serie;
- resultado;
- referencias específicas.
De hecho, la información relevante varía de un documento a otro.
Por eso, la configuración del proceso sigue siendo esencial.
Menos introducción manual de datos, menos posibilidades de error
Además, la transcripción manual es repetitiva y propensa a fallos.
Entre los errores habituales están:
- errores en las fechas;
- nombres mal escritos;
- números de certificado incompletos;
- asociación al trabajador equivocado;
- clasificación incorrecta;
- información omitida.
Así, la extracción automática puede eliminar gran parte de esta transcripción.
De este modo, los equipos se centran más en validar las excepciones y menos en copiar datos.
Sin introducción manual de datos, la información alimenta otros procesos
Sin embargo, la verdadera ventaja no termina en la extracción.
Cuando la información está estructurada, distintas áreas de la organización pueden utilizarla.
Por ejemplo, una fecha de caducidad puede generar una alerta.
Del mismo modo, una competencia puede alimentar una matriz de competencias.
El sistema también puede comparar al titular con el trabajador asociado al documento.
Además, la entidad emisora puede formar parte de las reglas de validación.
Los datos pueden alimentar dashboards e indicadores.
Así, la documentación pasa de una lógica estática a una lógica operativa.
Extraer no significa aprobar
Existe, no obstante, una distinción fundamental.
Poder extraer información de un documento no significa que la plataforma deba aprobarlo de forma automática.
Un certificado puede indicar “Trabajos en altura”, pero quizá aún haya que comprobar:
- si pertenece a la persona correcta;
- que sigue vigente;
- si corresponde al requisito del proyecto;
- que la entidad emisora es adecuada;
- si la formación es suficiente para la función;
- la existencia de otros requisitos obligatorios.
Por lo tanto:
extracción de datos ≠ decisión de cumplimiento
Es decir, la extracción reduce las tareas administrativas.
En cambio, el cumplimiento exige reglas, contexto y criterios de decisión.
Cuando el análisis humano sigue siendo necesario
De hecho, no todos los documentos son claros.
Hay documentos escaneados con baja calidad, información contradictoria, campos incompletos o terminología difícil de interpretar.
Por eso, en esos casos, la tecnología debe saber detenerse.
Cuando no hay información suficiente para tomar una decisión segura, el documento debe pasar a análisis humano.
Así, la automatización eficiente no es la que intenta decidirlo todo.
Es la que automatiza lo que está claro y encamina correctamente las excepciones.
Datos documentales al servicio de la operación
Con datos estructurados, resultan posibles procesos que antes exigían consultas manuales.
Por ejemplo:
- identificar documentos próximos a caducar;
- saber qué trabajadores tienen una competencia;
- ver los proveedores con requisitos pendientes;
- seguir la documentación por proyecto;
- alimentar dashboards de cumplimiento;
- identificar prioridades de análisis.
Como resultado, la información deja de estar encerrada dentro de los archivos.
En su lugar, queda disponible para apoyar la toma de decisiones.
De la documentación a la operación
La evolución puede resumirse así:
Modelo tradicional:
Documento → lectura humana → introducción manual → validación
Modelo apoyado por IA:
Documento → extracción de datos → estructuración → reglas → validación → decisión
No obstante, el documento sigue siendo la evidencia original.
Pero el equipo ya no tiene que repetir a mano la información que ya existe.
Menos introducción manual de datos. Más valor humano.
El objetivo de la inteligencia artificial en la gestión documental no debe ser sustituir el conocimiento de los equipos.
Al contrario, debe ayudarles a aprovecharlo mejor.
Un técnico especializado aporta más valor analizando una situación ambigua, una no conformidad o un requisito complejo que copiando una fecha de caducidad de un PDF a un campo.
De hecho, precisamente ahí está una de las mayores oportunidades de la automatización documental.
La idea es quitar a las personas las tareas repetitivas y devolverles tiempo para el trabajo que exige criterio, conocimiento y decisión.
La información ya existe dentro de los documentos.
La tecnología puede ayudar a extraerla. Y los equipos pueden centrarse en lo que realmente exige inteligencia humana.
Lea también: Automatización en la gestión documental y Reducción de costes y mejora de la productividad.
Para conocer el marco europeo sobre inteligencia artificial y transformación digital, consulte la estrategia digital de la Comisión Europea.