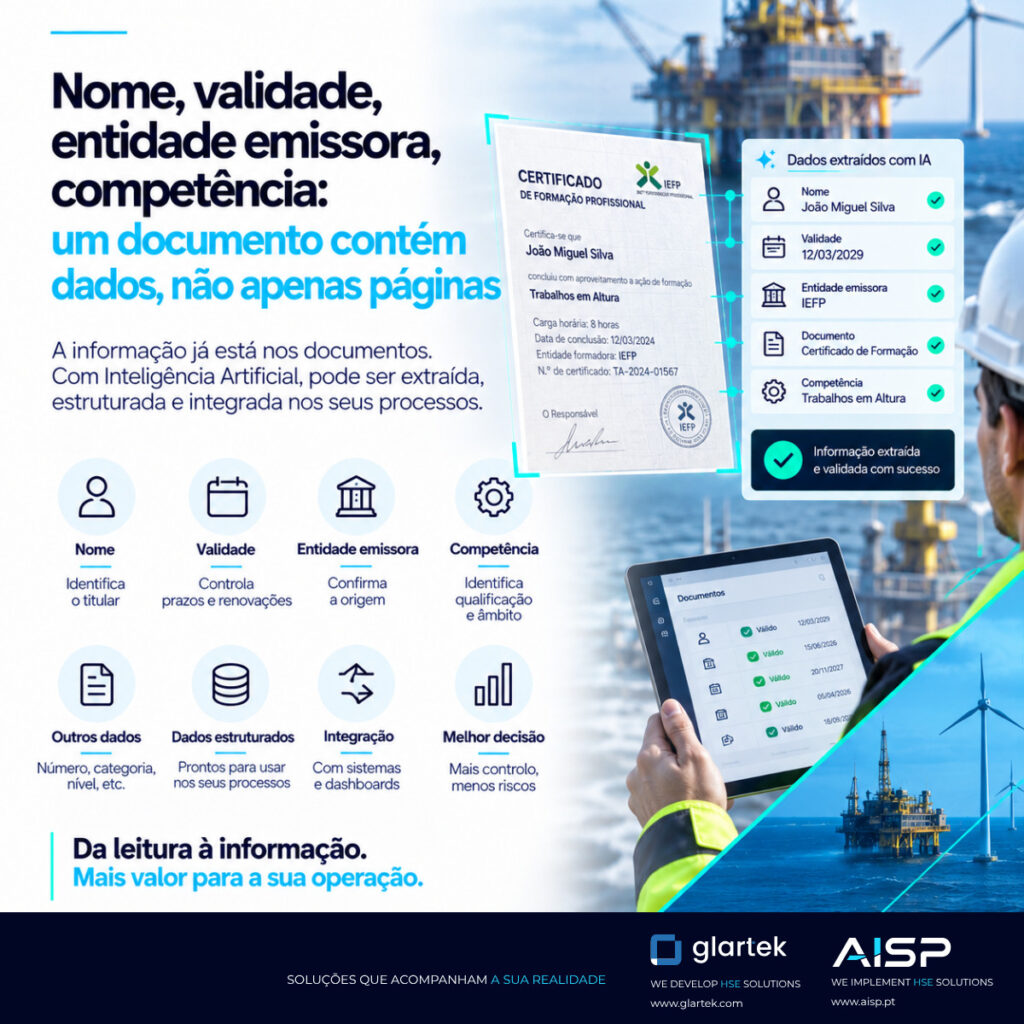
Um documento digital não é apenas um conjunto de páginas armazenadas numa plataforma. Os dados dos documentos também têm valor.
Dentro de um certificado, relatório, declaração, apólice, ficha técnica ou registo existe informação que pode ser identificada, estruturada e utilizada por outros processos da organização.
Nomes, datas, entidades emissoras, competências, números de certificado, referências, resultados ou prazos são exemplos de dados que muitas organizações continuam a consultar manualmente sempre que necessitam deles.
Por isso, a evolução da Gestão Documental passa precisamente por mudar esta lógica.
Em vez de tratar o documento apenas como um ficheiro, torna-se possível tratá-lo também como uma fonte de dados.
O documento já contém a informação
Por exemplo, considere um certificado de formação.
Visualmente, temos um documento.
Mas, do ponto de vista do processo, podemos ter diferentes elementos de informação:
- nome do trabalhador;
- número de identificação;
- formação realizada;
- competência adquirida;
- entidade formadora;
- data de emissão;
- data de validade;
- duração;
- referência do certificado.
Na verdade, cada um destes elementos pode ser relevante para uma decisão diferente.
Por exemplo, a data de validade pode alimentar um alerta.
Além disso, a competência pode ser relacionada com uma função.
A entidade emissora pode fazer parte das regras de validação.
Por fim, o titular pode ser comparado com o trabalhador a quem o documento foi associado.
A informação já existia. No entanto, o problema era permanecer apenas dentro da página.
Quando um PDF continua a exigir trabalho manual
Digitalizar processos não significa simplesmente substituir papel por PDF.
Se, depois de carregar um documento numa plataforma, alguém continuar a ter de o abrir, localizar os campos relevantes e introduzir os mesmos dados manualmente, uma parte importante do processo continua a funcionar como antes.
Isto torna-se particularmente relevante quando existem centenas ou milhares de documentos.
Assim, pequenas tarefas repetidas muitas vezes transformam-se em horas significativas de trabalho administrativo.
Além disso, aumentam as possibilidades de erro de transcrição, classificação ou associação.
Transformar conteúdo dos documentos em dados estruturados
Tecnologias de OCR e Inteligência Artificial permitem apoiar a identificação de informação existente nos documentos.
No entanto, o objetivo não é simplesmente reproduzir todo o texto.
Na verdade, é identificar os campos que têm significado para o processo.
Por exemplo, num certificado pode interessar a formação.
Numa apólice pode interessar a seguradora, o número da apólice e a validade.
Num certificado de equipamento podem interessar o número de série, inspeção e próxima revisão.
Numa ficha de aptidão podem existir elementos relevantes para determinar se a evidência apresentada é adequada ao requisito aplicável.
Assim, a estrutura depende sempre do tipo de documento e do processo que a organização pretende controlar.
Dados dos documentos podem alimentar validações
Quando os dados deixam de estar presos dentro dos documentos, podem ser utilizados pelas regras da plataforma.
Por exemplo, a extração da data de validade permite verificar automaticamente se o documento se encontra dentro do prazo definido.
Por exemplo, a identificação do titular pode ser comparada com o trabalhador associado.
Do mesmo modo, uma competência pode ser confrontada com os requisitos de determinada função.
A entidade emissora pode ser analisada de acordo com critérios previamente definidos.
Assim, a análise deixa de depender exclusivamente da leitura do ficheiro.
Dos dados dos documentos para as matrizes de competências
Esta abordagem é particularmente relevante em organizações que precisam de controlar competências.
Por exemplo, imagine uma empresa com centenas de trabalhadores e diferentes funções.
Em vez de manter a informação apenas dentro dos certificados, os dados extraídos podem ajudar a estruturar uma visão sobre:
- quem possui determinada competência;
- quando foi adquirida;
- até quando é válida;
- que evidência documental a suporta;
- para que funções é necessária;
- quem precisa de renovação.
No entanto, o documento continua a funcionar como evidência.
Mas a informação passa também a alimentar a gestão operacional.
Alertas baseados nos dados dos documentos
Além disso, outro exemplo é a validade.
Enquanto a data existir apenas dentro de um PDF, alguém terá de a consultar ou registá-la manualmente.
Depois de estruturada, pode gerar automaticamente:
- alertas de expiração;
- listas de documentos a renovar;
- notificações;
- indicadores;
- priorização de tarefas.
O documento deixa, assim, de ser passivo.
Assim, a informação nele contida passa a desencadear processos.
Dashboards sem abrir ficheiros
Além disso, a mesma lógica aplica-se aos indicadores.
Uma plataforma com dados estruturados pode apresentar informação como:
- documentos válidos;
- documentos expirados;
- trabalhadores por competência;
- fornecedores com documentação pendente;
- certificações a renovar;
- requisitos não satisfeitos;
- níveis de conformidade por projeto.
Desta forma, as equipas deixam de necessitar de abrir cada ficheiro para responder a perguntas operacionais básicas.
Dados extraídos dos documentos precisam de contexto
No entanto, extrair informação não significa automaticamente interpretá-la corretamente.
Uma data identificada num documento pode ser uma data de emissão, de validade, de inspeção ou de revisão.
Uma competência pode aparecer porque o trabalhador a possui ou apenas porque é mencionada num texto.
Do mesmo modo, uma entidade pode ser a entidade emissora, o cliente ou outra organização citada.
Por isso, uma solução robusta precisa de combinar:
extração + estrutura + regras + contexto.
Na verdade, é esta combinação que permite transformar texto em informação utilizável.
IA como apoio, não como ausência de controlo
A Inteligência Artificial pode acelerar significativamente a leitura e estruturação documental.
Mas devem existir mecanismos para lidar com incerteza.
Quando o sistema não consegue identificar um campo com segurança, encontra informação contraditória ou não dispõe de evidência suficiente, o processo deve permitir encaminhar o documento para análise humana.
A automação acrescenta valor quando reduz o trabalho repetitivo e preserva o rigor das decisões.
O documento passa a alimentar o processo
A grande mudança pode ser resumida de forma simples.
Num modelo tradicional:
Documento → consulta humana
Num modelo mais avançado:
Documento → dados → validação → processo → decisão
No entanto, o ficheiro continua a ser importante.
Mas deixa de ser o ponto final.
Passa a ser uma fonte de informação para diferentes componentes da organização.
De páginas para informação operacional
O potencial da nova geração de Gestão Documental está precisamente aqui.
Os documentos que as organizações já recebem contêm grande parte da informação necessária aos seus processos.
Por isso, a questão é saber utilizá-la.
Extrair e estruturar esses dados permite reduzir introdução manual, melhorar a rastreabilidade, acelerar validações e criar indicadores mais úteis para a operação.
Porque um documento não contém apenas páginas.
Contém dados que podem alimentar decisões.
Leia também: Automação na gestão documental e Inteligência Artificial e Machine Learning para deteção de padrões anómalos.
Para conhecer as regras aplicáveis ao tratamento de dados pessoais em documentos, consulte a Comissão Nacional de Proteção de Dados (CNPD).