
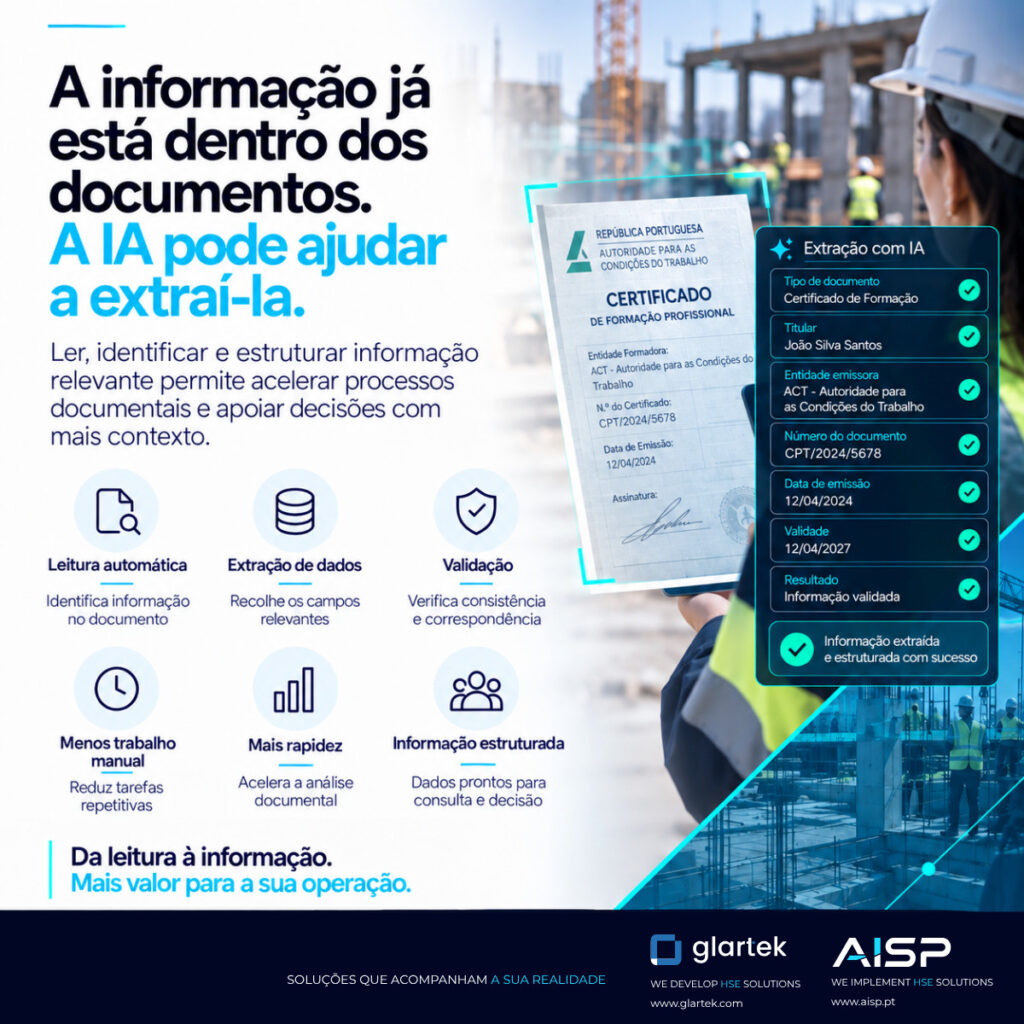
Les organisations traitent chaque jour des milliers de documents qui contiennent des informations essentielles à leur activité : certificats de formation, fiches d’aptitude médicale, polices d’assurance, déclarations, rapports d’inspection, certificats d’équipements, fiches techniques, licences, autorisations, registres de maintenance ou documentation des fournisseurs. L’extraction de données par IA permet de mieux exploiter ces informations.
En réalité, dans la plupart des cas, l’information nécessaire existe déjà.
Toutefois, le problème est qu’elle reste enfermée dans les fichiers.
Pour utiliser ces données, quelqu’un doit ouvrir le document, interpréter son contenu, repérer les champs pertinents, vérifier leur cohérence et ressaisir l’information dans une plateforme, un tableur ou un autre système.
Lorsque ce processus se répète des centaines ou des milliers de fois, il cesse d’être une simple tâche administrative.
Il devient alors un problème d’efficacité, de traçabilité et de maîtrise opérationnelle.
C’est précisément à ce stade que l’intelligence artificielle appliquée à la gestion documentaire commence à créer de la valeur.
Autrement dit, il ne s’agit plus seulement de numériser des documents.
Il s’agit de transformer une documentation non structurée en informations structurées, consultables et exploitables par les processus de l’organisation.
Des fichiers numériques à l’information exploitable
En effet, disposer de documents au format numérique ne signifie pas forcément disposer d’informations numérisées.
Par exemple, un PDF peut être stocké sur une plateforme et fonctionner exactement comme une feuille de papier.
L’équipe doit donc toujours :
- ouvrir le document ;
- rechercher les données pertinentes ;
- interpréter le contenu ;
- vérifier les dates et les noms ;
- copier les informations dans des champs ;
- contrôler les exigences ;
- décider si le document peut être approuvé.
Autrement dit, le fichier a été numérisé, mais le processus reste en grande partie manuel.
La véritable transformation commence lorsque l’information contenue dans le document peut être identifiée et structurée automatiquement.
Ainsi, un certificat n’est plus seulement un fichier nommé certificat.pdf.
Il peut fournir des données telles que :
Type de document : certificat de formation
Titulaire : João Silva
Organisme émetteur : organisme de formation identifié
Date d’émission : 12/04/2026
Date d’expiration : 12/04/2029
Formation : travail en hauteur
Numéro du certificat : référence identifiée dans le document
De plus, ces données peuvent ensuite être utilisées par les autres processus de la plateforme.
C’est là que le document commence réellement à devenir une information opérationnelle.
Que signifie l’extraction de données par IA ?
L’extraction de données par IA combine différentes technologies.
Selon la solution et le type de document, le processus peut faire appel à la reconnaissance optique de caractères, à la reconnaissance de structure, aux modèles de langage, à la classification documentaire, à l’identification d’entités et à des règles métier spécifiques.
De manière simplifiée, le flux peut se représenter ainsi :
Document → Lecture → Identification → Extraction → Structuration → Validation → Décision
Chaque étape a une fonction distincte.
1. Lecture du document
La première étape consiste à transformer le contenu du fichier en une représentation qui peut être traitée.
Par exemple, dans un PDF natif, une grande partie du texte peut déjà être disponible.
En revanche, pour un document scanné ou une photographie, il peut être nécessaire de recourir à l’OCR, Optical Character Recognition, pour reconnaître le texte présent dans l’image.
Mais reconnaître des caractères n’est qu’un début.
Savoir que les caractères « 12/04/2026 » apparaissent sur une page ne signifie pas encore comprendre ce que cette date représente.
2. Identification du type de document
Avant d’extraire des informations, il faut souvent comprendre quel document nous analysons.
S’agit-il d’un certificat ?
D’une fiche d’aptitude médicale ?
D’une police d’assurance ?
Ou d’une déclaration de conformité ?
D’un rapport d’inspection ?
D’une autorisation de travail ?
La classification documentaire est importante, car des types de documents différents exigent des informations différentes.
Par exemple, pour un certificat de formation, les éléments pertinents peuvent être :
- nom du stagiaire ;
- formation suivie ;
- organisme de formation ;
- date ;
- durée ;
- date d’expiration.
En revanche, pour une police d’assurance, les champs pertinents seront différents.
Pour une fiche d’aptitude médicale, ils seront encore différents.
C’est pourquoi une solution documentaire intelligente ne doit pas traiter tous les documents comme s’ils avaient la même structure.
3. Extraction de données par IA : Les champs pertinents
Une fois le document identifié, l’IA peut donc rechercher l’information nécessaire.
Par exemple :
- titulaire ;
- entreprise ;
- organisme émetteur ;
- numéro du document ;
- date d’émission ;
- date d’expiration ;
- identification de l’équipement ;
- type de formation ;
- fonction ;
- résultat ;
- signature ;
- référence contractuelle ;
- localisation ;
- immatriculation ;
- numéro de série.
Cependant, l’objectif ne doit pas être d’extraire tout le texte sans distinction.
Il doit être d’identifier l’information nécessaire à ce processus documentaire.
Cette distinction est donc importante.
En effet, extraire beaucoup d’informations ne produit pas forcément plus de valeur.
Dans un processus B2B, la valeur consiste à extraire les bonnes données et à les relier aux bonnes règles.
Extraire des données et valider des documents, ce n’est pas la même chose
C’est l’une des distinctions les plus importantes lorsqu’on parle d’IA appliquée à la gestion documentaire.
Par exemple, un système peut identifier correctement qu’un certificat contient :
« Formation au travail en hauteur »
et que sa date d’expiration tombe à une date donnée.
Mais cela ne signifie pas automatiquement que le document est conforme.
Il reste donc à répondre à d’autres questions :
- Le certificat appartient-il au bon intervenant ?
- La formation correspond-elle à celle exigée pour l’activité ?
- L’organisme émetteur est-il adéquat ?
- Le document contient-il les éléments obligatoires ?
- Le certificat est-il encore valide ?
- La formation couvre-t-elle le risque spécifique ?
- Existe-t-il une restriction ?
- Le projet impose-t-il des exigences supplémentaires ?
Par conséquent :
Extraction de données ≠ décision de conformité
L’extraction de données par IA fournit de l’information.
La validation, en revanche, utilise cette information pour analyser les exigences.
De l’information extraite aux règles métier
C’est ici qu’une plateforme de gestion documentaire commence à se distinguer d’un simple outil de lecture automatique.
Après l’extraction des données, il faut donc les relier aux règles configurées pour chaque processus.
Imaginez, par exemple, qu’une entreprise exige, pour une fonction donnée :
- une formation au travail en hauteur ;
- une aptitude médicale valide ;
- une formation de sécurité spécifique ;
- des documents d’identité ;
- une autorisation du projet.
La plateforme doit ainsi pouvoir évaluer chacune de ces preuves individuellement, puis les relier à la fonction et à l’activité.
L’analyse peut s’appuyer sur des questions telles que :
Le bon document a-t-il été présenté ?
Le titulaire correspond-il ?
La date d’expiration respecte-t-elle les limites définies ?
La formation indiquée correspond-elle à celle requise ?
Le document provient-il d’un organisme émetteur accepté ?
Tous les éléments obligatoires sont-ils présents ?
C’est ce lien entre données extraites + exigences configurées + contexte opérationnel qui fait de l’IA une composante réellement utile de la gestion documentaire.
L’importance du contexte
L’une des erreurs les plus courantes de la numérisation documentaire consiste à traiter la conformité comme une propriété isolée du document.
Or, un document peut être parfaitement valide et pourtant ne pas suffire dans une situation donnée.
Imaginez, par exemple, un intervenant affecté à deux activités :
- maintenance électrique ;
- travail en hauteur.
Sa fiche d’aptitude médicale peut indiquer une aptitude pour l’une des activités, sans fournir de preuve suffisante pour l’autre.
Autrement dit, le document n’est pas forcément invalide.
Il peut simplement ne pas suffire pour autoriser automatiquement toutes les activités.
Cet exemple montre pourquoi l’analyse documentaire a besoin de contexte.
C’est pourquoi une plateforme avancée doit pouvoir relier :
Document + personne + exigence + fonction + activité + risque + projet
Ce n’est qu’après avoir établi cette relation qu’il est possible de produire une décision opérationnelle réellement utile.
Le rôle de l’organisme émetteur
Par ailleurs, un autre exemple important est l’identification de l’entité qui a produit le document.
Par exemple, un certificat peut comporter une date valide et identifier correctement l’intervenant.
Mais il peut encore être nécessaire de déterminer :
- qui l’a émis ;
- si cet organisme est acceptable ;
- s’il correspond au type de document ;
- et s’il existe une règle spécifique au client ou au projet.
L’identification de l’organisme émetteur n’est donc plus un simple champ administratif.
Elle fait aussi partie de l’analyse de la preuve elle-même.
Avec l’IA, l’extraction de données permet d’identifier cette information lors de la lecture du document, puis de l’utiliser dans les règles de validation.
IA et validation multilingue
Dans les opérations internationales, un autre défi se présente : les documents peuvent arriver dans différentes langues.
Par exemple, une organisation peut recevoir des certificats en portugais, espagnol, français, anglais, allemand ou italien sur un même projet.
Dans un processus traditionnel, cette diversité peut donc allonger considérablement le temps d’analyse.
Cependant, l’IA peut faciliter :
- l’identification de la langue ;
- l’extraction d’informations ;
- la reconnaissance de notions équivalentes ;
- la structuration de champs communs ;
- la normalisation de l’information.
Toutefois, cela ne signifie pas que les différentes langues doivent être traitées sans contrôle.
En réalité, des termes en apparence similaires peuvent avoir des sens différents selon la législation, le contexte ou le type de document.
C’est pourquoi le processus doit continuer de s’appuyer sur des règles et des exigences définies au préalable.
Automatiser ne signifie pas supprimer la vérification humaine
Un système documentaire robuste ne doit pas chercher à automatiser toutes les décisions.
D’autant qu’il existera toujours des situations ambiguës.
Par exemple, un document peut :
- être partiellement illisible ;
- présenter des informations contradictoires ;
- ne pas identifier clairement le titulaire ;
- comporter une signature difficile à vérifier ;
- mentionner une formation proche, mais pas exactement conforme à l’exigence ;
- être incomplet ;
- comporter des restrictions ;
- utiliser une terminologie non reconnue.
Dans ces situations, la plateforme doit considérer qu’il n’existe pas de preuve suffisante pour une décision automatique.
La bonne réponse peut donc être :
Vérification manuelle nécessaire.
Ce principe est par conséquent essentiel.
Autrement dit, l’IA doit réduire le travail répétitif, et non transformer l’incertitude en approbation.
La notion de confiance dans l’extraction
Toutes les informations identifiées par l’IA n’auront pas le même degré de certitude.
Par exemple, un champ clairement identifié comme :
Date d’expiration : 15/09/2027
peut présenter un niveau de confiance élevé.
À l’inverse, une date trouvée dans un document peu lisible peut présenter un niveau de confiance plus faible.
Cette information peut donc servir à définir différents comportements.
Par exemple :
Confiance élevée + exigence claire
→ traitement automatique.
Confiance intermédiaire
→ validation supplémentaire.
Enfin, confiance faible ou information contradictoire
→ analyse humaine.
Ce type d’architecture aide à accroître l’automatisation sans compromettre la qualité des décisions.
De l’extraction de données par IA aux alertes automatiques
Lorsque les dates n’existent plus uniquement dans les documents et deviennent des informations structurées, de nouveaux processus deviennent possibles.
La plateforme peut ainsi identifier automatiquement :
- les documents qui expirent dans les 30 prochains jours ;
- les certificats dont la validité prend fin avant la clôture d’un projet ;
- la documentation déjà expirée ;
- les intervenants concernés ;
- les fournisseurs auxquels il manque des documents critiques.
Autrement dit, le contrôle ne dépend plus de quelqu’un qui ouvre le document pour vérifier la date.
L’information est déjà disponible pour générer des alertes.
Des données structurées pour des tableaux de bord utiles
La même logique s’applique aussi aux indicateurs.
Lorsque les documents ne sont que des fichiers, produire des indicateurs exige un travail supplémentaire.
Lorsque l’information est structurée, il devient possible de visualiser :
- le pourcentage de documentation conforme ;
- les documents en attente ;
- la documentation expirée ;
- les documents à renouveler ;
- les fournisseurs présentant le plus de non-conformités ;
- les intervenants dont les exigences sont incomplètes ;
- les équipements dont la documentation est en attente ;
- les délais moyens de validation ;
- le volume documentaire par projet.
La documentation commence ainsi à produire des données de gestion.
Moins de saisie manuelle, c’est aussi moins d’erreurs
La saisie manuelle de données est une tâche répétitive.
Plus le volume documentaire est important, plus le risque d’erreurs augmente, par exemple :
- dates incorrectes ;
- noms mal saisis ;
- numéros de certificat incomplets ;
- association au mauvais intervenant ;
- classification documentaire incorrecte ;
- champs oubliés.
Automatiser l’extraction de données par IA n’élimine pas toutes les erreurs.
Mais cela peut réduire considérablement la quantité d’informations à ressaisir.
L’équipe se concentre ainsi davantage sur l’analyse des exceptions et moins sur la transcription.
La traçabilité reste essentielle
Chaque fois qu’une plateforme utilise l’IA pour appuyer une décision documentaire, il doit être possible de comprendre l’origine de l’information.
Par exemple, dans un processus robuste, il doit être possible de savoir :
- de quel document un champ a été extrait ;
- quelle information a été identifiée ;
- quelle règle a été appliquée ;
- quel a été le résultat ;
- s’il y a eu une validation manuelle ;
- qui a pris la décision finale ;
- quand cette décision a été prise.
C’est pourquoi l’automatisation ne doit pas réduire la traçabilité.
Au contraire, idéalement, elle doit l’accroître.
Sécurité et contrôle des accès
Par ailleurs, l’utilisation de l’IA ne supprime pas les exigences traditionnelles de la gestion documentaire.
En effet, les informations sensibles exigent toujours un contrôle.
Les organisations doivent donc prendre en compte :
- les profils d’accès ;
- les autorisations ;
- la journalisation des activités ;
- la conservation des documents ;
- l’historique des modifications ;
- la sécurité de l’information ;
- les politiques internes de protection des données.
L’objectif n’est pas simplement de rendre les documents plus accessibles.
Il s’agit de rendre l’information accessible aux bonnes personnes, pour les bons processus et avec des niveaux de contrôle adaptés.
Intégration : Quand l’information commence à circuler
Un autre avantage important apparaît lorsque les données extraites peuvent alimenter d’autres systèmes.
Grâce aux API et aux intégrations, certaines informations peuvent être mises à la disposition :
- des systèmes HSE ;
- de l’ERP ;
- des plateformes de gestion des fournisseurs ;
- des systèmes de contrôle d’accès ;
- des applications opérationnelles ;
- des tableaux de bord de l’entreprise ;
- des systèmes de ressources humaines ;
- des outils de Business Intelligence.
Imaginez, par exemple, qu’un intervenant ne remplisse plus une exigence documentaire critique.
Cette information ne reste alors plus confinée au module documentaire.
Elle peut aussi influencer directement d’autres processus opérationnels.
C’est à ce moment que la gestion documentaire cesse définitivement d’être un système isolé.
Un exemple pratique
Prenons un fournisseur qui charge un certificat de formation sur une plateforme.
Dans un processus traditionnel :
- le document est soumis ;
- un technicien ouvre le fichier ;
- il identifie l’intervenant ;
- il recherche la formation ;
- il vérifie la date d’expiration ;
- il saisit les données ;
- il les compare aux exigences ;
- il prend une décision.
En revanche, dans un processus appuyé par l’IA, une partie de ce flux peut être différente.
Le système peut :
- recevoir le document ;
- identifier le type de document ;
- reconnaître l’intervenant ;
- identifier l’organisme émetteur ;
- extraire les dates ;
- identifier la formation ;
- structurer l’information ;
- comparer les données aux exigences configurées ;
- détecter les incohérences ;
- transmettre uniquement les exceptions pour analyse.
Ainsi, le technicien n’est plus principalement utilisé comme opérateur de saisie.
Il peut se concentrer sur les cas qui exigent réellement expertise et décision.
L’objectif n’est pas de remplacer le document
Même dans un processus fortement automatisé, le document reste important.
C’est la preuve originale.
La différence réside dans la manière dont l’information contenue dans cette preuve est utilisée.
Avant :
fichier → consultation manuelle
Après :
fichier → information structurée → règles → contexte → décision
C’est cette évolution qui peut transformer la gestion documentaire.
Où se trouve le véritable retour sur investissement ?
Le bénéfice de l’IA dans la gestion documentaire ne doit pas se mesurer uniquement au nombre de documents traités automatiquement.
Au contraire, il doit être analysé de façon plus large.
Il peut par exemple inclure :
Moins de temps administratif
Réduction des tâches de lecture et de saisie manuelle.
Plus de cohérence
Application plus uniforme des règles définies.
Plus de rapidité
Traitement documentaire plus rapide.
Une meilleure traçabilité
Information structurée sur chaque décision.
De meilleurs indicateurs
Données disponibles pour le pilotage et le reporting.
Une plus grande capacité de montée en charge
Davantage de volume documentaire sans hausse proportionnelle du travail manuel.
Des équipes plus concentrées
Les techniciens peuvent se consacrer aux exceptions et aux situations critiques.
La technologie ne fonctionne bien que si le processus est bien défini
Il existe toutefois une condition essentielle.
L’IA ne remplace pas la définition du processus documentaire.
Avant d’automatiser, il faut donc savoir :
- quels documents existent ;
- quels champs sont pertinents ;
- quelles exigences doivent être respectées ;
- quelles preuves sont acceptées ;
- quelles exceptions existent ;
- quelles décisions peuvent être automatiques ;
- quelles situations exigent une intervention humaine.
Si ces règles ne sont pas claires, l’automatisation ne fait qu’accélérer un processus mal structuré.
Une mise en œuvre efficace commence donc par la conception du processus.
Ensuite, la technologie peut aider à le déployer à grande échelle.
De la lecture à l’information. De l’information à la décision
L’évolution de la gestion documentaire suppose de ne plus traiter les documents comme de simples fichiers stockés.
En réalité, l’information existe déjà.
Elle se trouve dans les certificats, rapports, licences, déclarations, polices et registres que les organisations reçoivent chaque jour.
L’intelligence artificielle peut ainsi aider à :
lire, identifier, extraire, structurer et relier cette information.
Mais la véritable valeur apparaît lorsque les données ne sont plus isolées et sont utilisées dans le contexte du processus.
Lorsque l’information documentaire alimente des règles.
Mais aussi lorsque les exigences sont reliées aux intervenants, aux entreprises, aux équipements et aux activités.
Lorsque les données génèrent des alertes et des indicateurs.
Et lorsqu’une décision qui ne peut être prise en toute sécurité est transmise pour analyse humaine.
C’est à ce stade que la gestion documentaire cesse d’être un simple référentiel.
Elle devient une infrastructure d’information au service de l’exploitation.
L’information est déjà dans les documents.
L’IA peut aider à l’extraire, à la structurer et à la transformer en valeur pour l’organisation.
À lire aussi : Identification de l’organisme émetteur : Pourquoi ce sujet n’est plus seulement administratif et L’avenir de la gestion documentaire : Du référentiel documentaire à la plateforme intelligente.
Pour connaître les orientations européennes sur l’intelligence artificielle, consultez la Commission européenne.